# 如何通过gpt-4o官方测评图表,寻找最适合自己的模型
本月,openai发布了最新的gpt-4o,并给出了文本评测的结果。
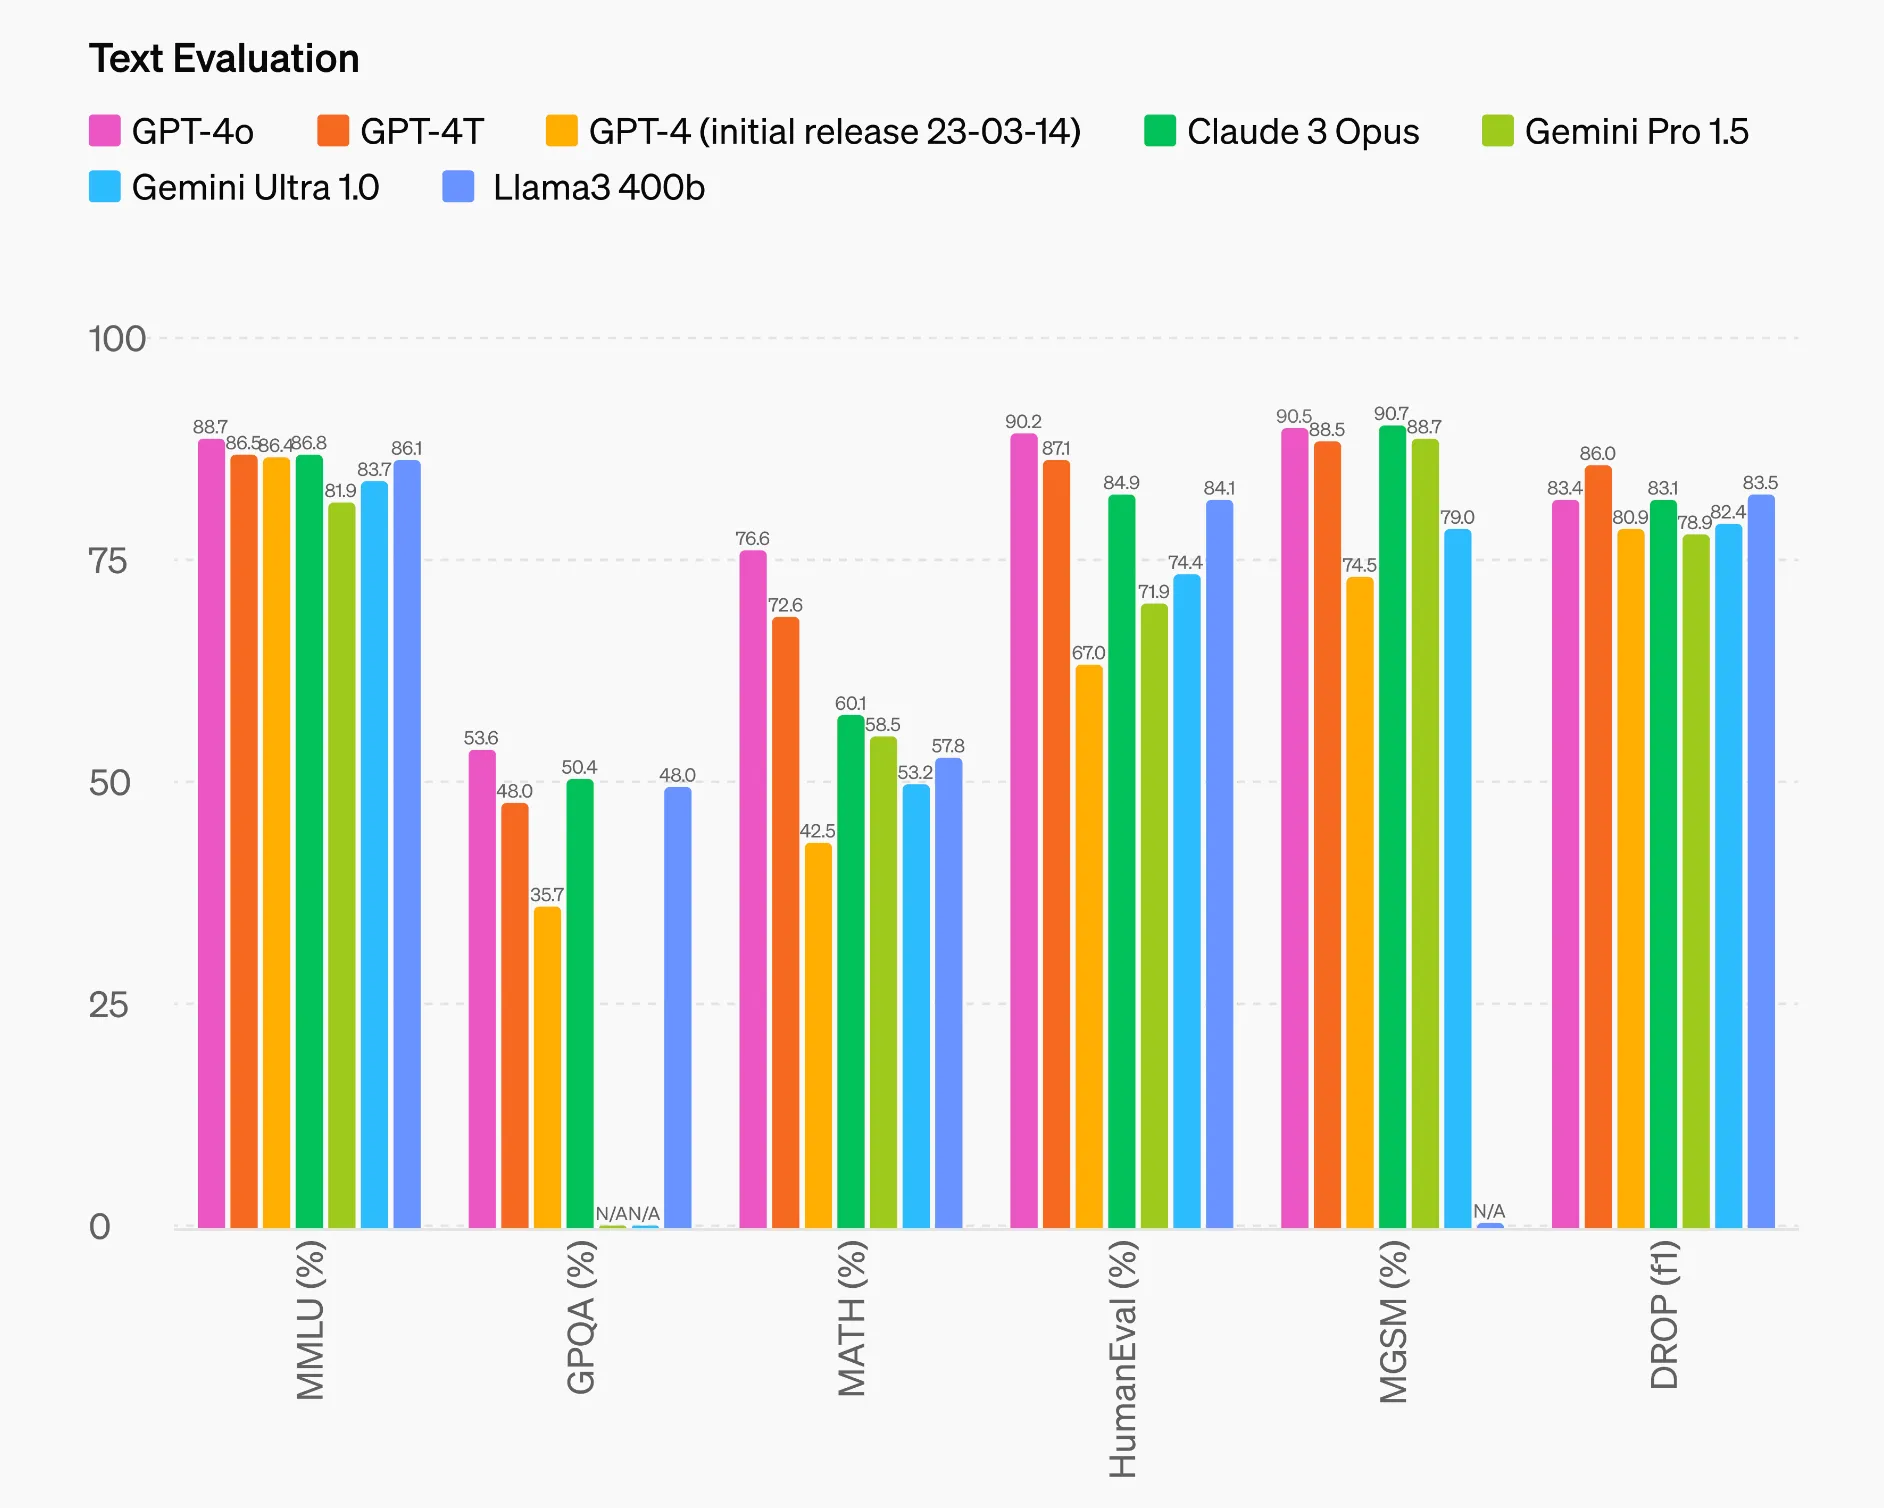
通过这些统计数据,可以帮助我们选择最优的模型
## <a id="i"></a>选择最优模型
1. **多任务语言理解**上,建议选择 gpt-4o
2. **研究生水平、复杂任务上,最好哪个都别选**,自己去搜索、阅读。 原因是:即使最优秀的gpt-4o,正确率才有53.6%,正确率太低了。回答一个问题,一半的概率是错误的。 这谁敢放心啊。
3. 在**数学问题**上,建议选择 gpt-4o。 但是做好三成答案错误的心理准备。
4. **编写代码**问题上, 建议选择 gpt-4o
5. **多语言小学数学问题**,建议首选claude 3, 其次是:gpt-4o
6. **阅读理解及推理**:选择gpt-4T
## <a id="i-2"></a>测试的模型
openai测试了自己和其它3家公司的产品。
也就是说,openai认为, **只有这3家产品,能称得上是ChatGPT的竞争对手**。
**gpt-4系列:** openai公司的产品
**claude3:** 据说是ChatGPT的最强竞争对手,由openai离职人员创办,谷歌有投资
**Gemini:** 互联网搜索巨头谷歌出品的AI
**Llama3 400b:** 是Meta(Facebook的母公司)出品的AI产品
## <a id="i-3"></a>测试项目
### <a id="1MMLU"></a>1.MMLU (%):
Measuring Massive Multitask Language Understanding
测试模型在大规模多任务语言理解上的表现。
### <a id="2GPQA"></a>2.GPQA (%):
Graduate-Level Google-Proof Q&A Benchmark
测试模型在研究生水平、难以通过简单搜索解答的问题上的表现。
### <a id="3MATH"></a>3.MATH (%):
Measuring Mathematical Problem Solving with the MATH Dataset
测试模型在数学问题解决上的表现。
### <a id="4HumanEval"></a>4.HumanEval (%):
Evaluating Large Language Models Trained on Code
测试模型在代码生成和编程任务上的表现。
### <a id="5MGSM"></a>5.MGSM (%):
Multilingual Grade School Math Benchmark
测试模型在多语言小学数学问题上的表现。
### <a id="6DROP_f1"></a>6.DROP (f1):
Discrete Reasoning Over Paragraphs
测试模型在阅读理解和需要离散推理的段落信息提取任务上的表现。
参考文章:
这篇文章里,有详细的测试方法及测试问题: https://github.com/openai/simple-evals
## <a id="i-4"></a>好工具推荐
一个集美剧、音乐和AI工具为一体的服务商:
<http://mrw.so/6gAybQ>
[](../../9.legacy-assets/9c3aabe731284aa170edcfbd.png)